Gemini API tools: loont ophalen?
Gemini API tools pas laden als ze nodig zijn? Bereken tokens en kosten, inclusief extra zoekaanroepen. Een grote context kan je besparing omkeren.
Vijftig tools met elk 400 tokens aan definities kosten samen 20.000 tokens, nog vóór je vraag. Dat is een rekenvoorbeeld, geen benchmark. Met Gemini API tools kun je die definities voortaan uitstellen. Google kondigde de preview op 19 november aan. Maar de extra zoekaanroep kan de besparing ook opeten.
Gemini API tools: alleen laden is niet genoeg
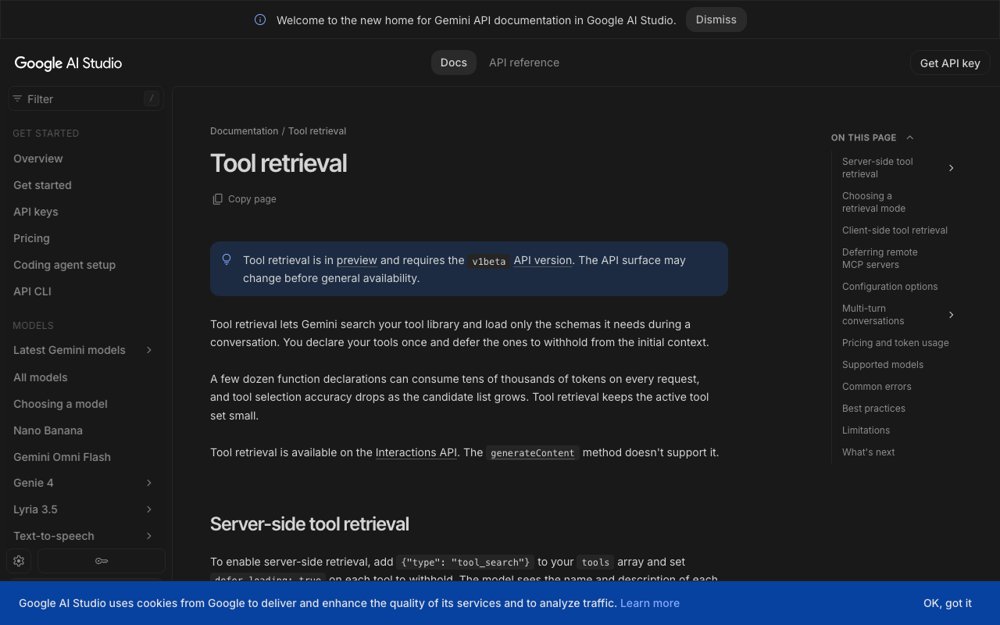
Een schema beschrijft welke invoer een functie verwacht. Tool retrieval houdt zulke details buiten de context totdat ze nodig zijn. Naam en korte beschrijving blijven wel zichtbaar. De preview gebruikt de Interactions API met v1beta; generateContent ondersteunt dit niet.
Voeg {"type":"tool_search"} toe en zet defer_loading: true bij uitgestelde functies. Je eigen code voert de functie daarna nog steeds uit. Google beschrijft dit in de aankondiging en documentatie van 19 november 2026.
Bereken ook de extra zoekaanroep
Vul je eigen aantallen in. De voorbeeldwaarden zijn aannames. Dit vereenvoudigde model rekent met dezelfde context en gemiddeld geladen schema’s bij elke gewone én extra aanroep. Uitvoer, caching, groeiende gesprekken en verschillen tussen schema’s tellen niet mee.
Formule en grenzen van deze berekening
Statisch: A × (C + N × S). Ophalen: A × (1 + Q) × (C + N × D + K × S + F). A is gewone aanroepen per dag, C overige context, N alle tools, S volledig schema, D korte beschrijving, K gemiddeld geladen tools, F vaste zoekinstructies en Q extra zoekaanroepen per gewone aanroep. Kosten = tokens ÷ 1.000.000 × jouw tarief.
We tellen de korte beschrijving én het volledige schema van geladen tools mee. Dezelfde gemiddelde set telt ook mee bij de extra zoekaanroepen. Dit is een scenariovergelijking, geen exacte reconstructie van Googles tokenadministratie. Meet daarna total_input_tokens en total_tool_use_tokens in je eigen verkeer.
Een grote context kan ophalen duurder maken
In onze grote voorbeeldstand is statisch laden 2.000 + 50 × 400 = 22.000 tokens per gewone aanroep. Ophalen wordt 2 × (2.000 + 50 × 30 + 2 × 400 + 100) = 8.800 tokens. De factor twee staat voor de gewone aanroep plus één extra zoekaanroep.
Verander alleen de bibliotheek naar 10 tools en de context naar 30.000 tokens. Dan wordt statisch laden 34.000 tokens en ophalen 62.400. De zoekaanroep herhaalt nu vooral gesprekscontext. De grafiek toont deze berekening; dit zijn geen metingen van Google.
Laat veelgebruikte functies gewoon geladen
Alles uitstellen is een slechte standaard. Begin met functies die zelden nodig zijn; houd de dagelijkse functies direct beschikbaar. Google adviseert dat ook. Ophalen heeft geen afzonderlijke toeslag, maar de gebruikte tokens worden wel afgerekend. Geladen schema’s blijven bovendien in het gesprek.
Ook dit rekenmodel heeft een zwakke plek: het gebruikt gemiddelden. Een lange conversatie kan steeds meer schema’s verzamelen. Een lage tokenuitkomst bewijst evenmin dat de juiste functie wordt gekozen. Controleer daarom verkeerde toolkeuzes en responstijd naast kosten.
Diezelfde scheiding tussen techniek en echte werking speelt bij onze uitleg over van AI chat naar teamworkflow. Voor een contentproces zijn daarnaast creatieve content schrijven met AI en WP SEO AI andere taken dan het kiezen van een functie.
Direct laden
Uitstellen en meten
Welke functies stel je bij je volgende koppeling uit?
- Noteer welke functies je agent werkelijk gebruikt en welke alleen beschikbaar moeten blijven.
- Vul de calculator met aantallen uit die koppeling. Test ook een lang gesprek en een extra zoekaanroep.
- Vergelijk daarna dezelfde taken met en zonder ophalen. Leg tokens, responstijd en verkeerde toolkeuzes vast.
Voor Media en Internet telt zo’n werkende koppeling meer dan een lange lijst beschikbare functies. Onze projecten laten zien in welke producten zulke keuzes terechtkomen. Bij een volgende previewwijziging kijken we of geladen schema’s en zoekkosten anders worden behandeld.
Bronnen: Google, “Introducing Tool Retrieval in the Gemini API”, 19 november 2026; Google Gemini API Documentation, “Tool retrieval”, geraadpleegd 20 november 2026. Aanleiding: Unite.AI, 19 november 2026.
Je context kan de besparing omkeren
Vergelijk de korte en lange voorbeeldcontext met je eigen aantallen.
Bereken je toolkosten