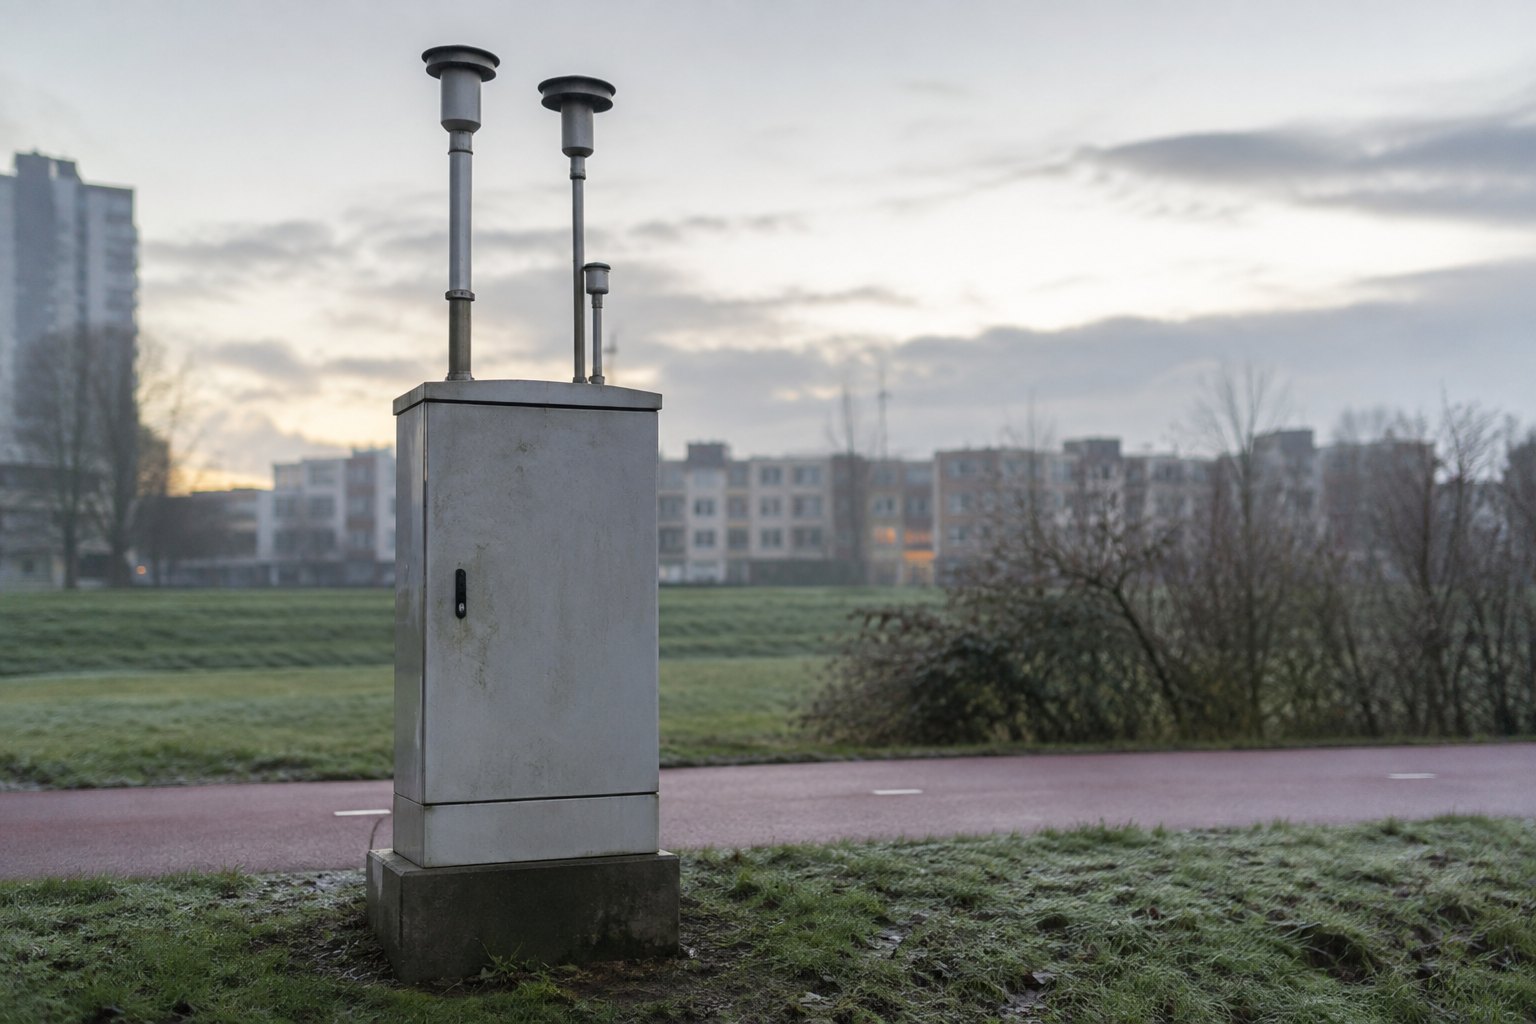
Vannacht liep de uurcron van mijn luchtkwaliteitssite voor het eerst echt, en hij kwam terug met 48 plaatsen. Ik had er 50 gebouwd. Twee waren stil weggevallen, en met die twee plaatsen verdwenen ook hun pagina’s. Geen foutmelding, geen alert. Alleen twee URL’s die vanaf dat moment een 404 zouden geven.
De oorzaak was banaal: een 429. Rate limiting op de laatste twee stations van de reeks. Maar de les eronder is de moeite waard, want die geldt voor elke site die pagina’s uit een API haalt.
Wat ik bouwde
Het RIVM heeft een open API voor Luchtmeetnet: alle officiële meetstations in Nederland, met uurwaarden voor fijnstof (PM2.5 en PM10), stikstofdioxide en ozon. Gratis, geen sleutel nodig. Ik haal er elk uur 94 stations op en zet daar 50 plaatspagina’s van, met een postcode-zoeker via PDOK erbij.
Twee dingen die ik daarbij moest verzinnen. De API geeft af en toe een negatieve meting — dat is meetruis, geen schone lucht — dus die gooi ik eruit voordat er iets op de site komt. En ik toon elke waarde tegen twee normen: de WHO-advieswaarde uit 2021 en de EU-grenswaarde. Die twee liggen ver uit elkaar. Eén norm kiezen zou netter staan, maar het is oneerlijk tegenover de lezer die wil weten of het nu meevalt of niet.
Waarom een 429 hier erger is dan een lege pagina
Bij de meeste API-koppelingen is een mislukte call een schoonheidsfoutje. Een blok blijft leeg, je ziet een streepje, klaar. Hier niet. Het aantal stations bepaalde het aantal pagina’s, dus een station dat wegviel sloopte een URL uit de sitemap.
Dat is precies het soort schade dat je pas weken later merkt. Google heeft die pagina gecrawld, geïndexeerd, misschien al een positie gegeven. Komt hij terug en krijgt hij een 404, dan gaat de pagina eruit. Bij de volgende cron-run staat hij er weer, want dan doet het station het weer. Zo’n knipperlicht is het slechtste signaal dat je een crawler kunt geven. Dan liever een pagina met cijfers van een uur oud.
De fix is twee regels werk. De vorige goedgekeurde snapshot blijft bewaard, en bij elke nieuwe ronde vul ik daaruit de stations aan die nu faalden — met hun oude meettijd erbij, zodat de bezoeker ziet dat het cijfer niet van dit uur is. Daarnaast ging de pauze tussen de calls van 0,3 naar 0,45 seconde. Sindsdien geen 429 meer.
De gouden regel die ik hieruit meeneem: een URL die bestaat mag nooit verdwijnen door een netwerkfout. Als het aantal pagina’s op je site afhangt van of een API meewerkt, heb je geen site maar een gokje. Bouw eerst het vangnet, dan de pagina’s.
In dezelfde keten zit trouwens nog een poort: voordat er iets naar de server gaat, controleert het script of de set compleet en vers genoeg is. Halve set? Dan gaat er niks live en blijven de oude cijfers staan. Ook hier: een uur oude data is beter dan een halve waarheid.
De tweede les: open data is gratis, de metadata niet
Naast de luchtdata heb ik deze week de officiële bekendmakingen van gemeenten uitgeplozen — de kennisgevingen die elke gemeente verplicht publiceert. Die zijn via een open zoekdienst op te halen, en de volumes zijn groter dan ik dacht. Twaalf maanden, alleen het Gemeenteblad:
Onderwerp |
Per jaar |
|---|---|
Kapvergunning |
32.444 |
Evenementenvergunning |
26.496 |
Dakkapel |
20.286 |
Gehandicaptenparkeerplaats |
10.885 |
Zonnepanelen |
1.452 |
Zoek je niet op woorden in de titel maar op de activiteitsindex, dan wordt het nog groter: ruim een miljoen bouwmeldingen per jaar, bijna 150.000 keer kappen.
En toen kwam de tegenvaller. Ik wilde die meldingen op een kaart en op plaatspagina’s zetten, dus ik had per melding een locatie nodig. Van ruim 20.000 dakkapel-meldingen heeft 65% een coördinaat en staat bij 71% de postcode ergens in de titel — maar het veld waar de postcode hoort te staan is in slechts 13% van de gevallen gevuld. Amsterdam, Rotterdam en Den Haag leveren de slechtste metadata van allemaal. Juist de steden met het meeste volume.
Oplossing: waar een coördinaat staat, vraag ik het adres op via de reverse-zoekdienst van PDOK. Getest op zo’n 0,4 meter nauwkeurig, en gratis. Zonder die omweg had ik een derde van mijn data weg moeten gooien.
En de domste fout van de week
WordPress laadt élk PHP-bestand dat in de map mu-plugins staat. Mijn paginatemplate stond daar ook, dus die werd bij iedere pageview los uitgevoerd, buiten zijn context. Bestand naar een submap verplaatst en het probleem was weg. Een uur zoeken voor een fout die je één keer maakt.
Wat ik van deze week overhoud: bij open data zit het werk nooit in het ophalen. Dat is een uur. Het werk zit in wat je doet als de bron even nee zegt, en in de velden die iemand anders vergeten heeft in te vullen.